Эксперты: ИИ может испортить опросы, поскольку «силиконовая выборка» запрашивает общественное мнение у компьютеров, а не у людей
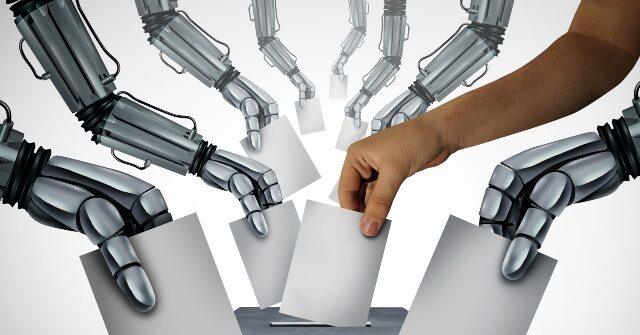
Стартап, занимающийся искусственным интеллектом, недавно провел, казалось бы, стандартный опрос общественного мнения о политике в области материнского здоровья, но ответы опроса были получены исключительно на основе компьютерного моделирования, а не реальных людей, использующих новую технику, называемую «силиконовая выборка».
Два профессора объясняют в недавнем Нью-Йорк Таймс гостевое эссе что об инциденте стало известно, когда Axios опубликовал статью о политике охраны материнского здоровья, в которой сослался на выводы о том, что большинство людей доверяют своим врачам и медсестрам. Первоначально в статье не сообщалось, что эти результаты были получены ИИ, а не людьми-респондентами. При более внимательном изучении источников выяснилось, что опрос общественного мнения на самом деле представлял собой компьютерную симуляцию, проведенную стартапом в области искусственного интеллекта Aaru, без участия реальных людей в формировании этих мнений. Впоследствии Axios добавил примечание редактора и пояснение, подтверждающее этот факт.
По словам профессоров, эта практика, известная как кремниевая выборка, быстро набирает обороты в сфере опросов. Концепция отбора проб кремния проста и привлекательна для многих специалистов в области исследований. Большие языковые модели продемонстрировали способность генерировать ответы, которые точно имитируют человеческие ответы, создавая то, что социологические компании рассматривают как возможность имитировать ответы опроса со значительно меньшими затратами и временем по сравнению с традиционными методами опроса.
Привлекательность метода отбора проб кремния обусловлена растущими проблемами, с которыми сталкиваются традиционные методы опроса. В последние годы эффективно проводить телефонные опросы стало в геометрической прогрессии. Интернет-опросы сталкиваются с существенной неопределенностью в отношении качества и репрезентативности выборки. Кремниевая выборка, похоже, предлагает решение, устраняя то, что многие считают беспорядочным и дорогостоящим компонентом опроса: фактически спрашивать реальных людей, что они думают.
Однако критики утверждают, что такой подход фундаментально подрывает всю цель опросов общественного мнения. По мнению авторов, Лейфа Уэзерби, директора Лаборатории цифровой теории Нью-Йоркского университета, и Бенджамина Рехта, профессора электротехники и компьютерных наук Калифорнийского университета в Беркли, данные общественного мнения выполняют решающие функции в принятии политических решений, политической стратегии и социальных науках. Эти данные имеют подлинную ценность только тогда, когда они точно суммируют убеждения и мнения реальных людей.
Они пишут:
Но это подрывает саму идею опроса общественного мнения. Общественное мнение используется для определения политики, политики и социальных наук, и оно имеет ценность только постольку, поскольку оно обобщает убеждения и мнения реальных людей. Использование моделирования человеческого мнения вместо реального только ухудшит нашу разрушенную информационную экосистему и посеет недоверие. Нам не следует обращаться к искусственному обществу, чтобы попытаться понять наше настоящее.
Журналист Уолтер Липпман в своей влиятельной книге «Общественное мнение» 1922 года писал, что люди формируют «картины в своей голове» обществ, в которых они живут. Он назвал эти картины «фикциями» и «псевдосредой», утверждая, что демократии нужны инструменты для исправления этих картин, и что опросы общественного мнения могут сыграть эту роль. Опросы никогда не будут идеальными, но г-н Липпманн считал, что они имеют решающее значение для того, чтобы приблизить нас к точному пониманию воли людей.
Появление кремниевых образцов поднимает фундаментальные вопросы о цели и обоснованности исследований общественного мнения в современную эпоху. Если данные опросов больше не отражают реальные человеческие точки зрения, а вместо этого отражают то, что системы искусственного интеллекта предсказывают, что люди могут сказать, вся основа исследования общественного мнения становится сомнительной.
Проблемы выходят за рамки теоретических дебатов о методологии. Когда средства массовой информации, политики и исследователи полагаются на данные опросов при принятии решений, они действуют исходя из предположения, что эти данные отражают подлинные общественные настроения. Если это предположение окажется ложным, поскольку данные получены от моделирования ИИ, а не от реальных людей, решения, основанные на такой информации, могут не соответствовать реальным потребностям и предпочтениям населения.
Директор социальных сетей Breitbart News Уинтон Холл, автор мгновенного бестселлера Красный код: левые, правые, Китай и гонка за контроль над ИИсказал, что ИИ опасен, когда предполагается, что он заменит людей, потому что ему присуща «врожденная» предвзятость влево.
Во время недавнего выступления в передаче Stinchfield Tonight на канале Real America Voice Холл объяснил, как возникает предвзятость:
Стинчфилд сказал: «Я постоянно слышу, что во многих моделях ИИ существует присущая им предвзятость».
Он спросил: «Насколько плоха предвзятость?»
Холл сказал: «На самом деле это первая глава Code Red. И я потратил два года на изучение каждого исследования, каждого официального документа, каждой рецензируемой статьи в академическом журнале. И одним из самых ошеломляющих открытий является то, что даже левые академические круги признают, что существует врожденная предвзятость к левым политическим и большим языковым моделям LLM. И поэтому это основано на данных обучения, которые в основном состоят из таких вещей, как Википедия, которая склоняется влево, Reddit, который И поэтому одна из вещей, которые мы должны сделать для родителей, бабушек и дедушек и педагогов, — это действительно помочь сохранить эти навыки критического мышления. Чтобы молодые люди не думали, что они получают нейтральную информацию, потому что это не так».
Полную версию гостевого эссе читайте на сайте Нью-Йорк Таймс здесь.